Срочное техническое обслуживание всех основных маршрутизаторов


В настоящее время мы проводим срочное техническое обслуживание всех наших основных маршрутизаторов. Обслуживание проводится поочередно. В ходе этих работ снижается общая избыточность сети. Мы не ожидаем перебоев в работе, но вы можете заметить увеличение задержки.

Это техническое обслуживание обеспечивает долгосрочную безопасность и стабильность нашей инфраструктуры. Благодарим вас за понимание и терпение.

Сетевой стек Hetzner Cloud — история и технический обзор


Эта статья — первая часть серии материалов, посвященных эволюции сетевых стеков, лежащих в основе Hetzner Cloud, и их архитектуры. В этой статье мы рассмотрим проделанную нами разработку и то, как работает текущий сетевой стек на основе Open vSwitch. Хотя сетевой стек для облачных серверов и балансировщиков нагрузки схож, мы сосредоточимся на облачных серверах и хостах виртуализации (хостах виртуальных машин), поскольку они предоставляют больше сервисов и функций.

Для краткости мы исключим из рассмотрения плоскость управления облаком, которая управляет всеми серверами, балансировщиками нагрузки, частными сетями и т.д., и рассмотрим только сетевой стек на хостах.

Как мы работаем
Для работы всех облачных продуктов необходимы универсальные и надежные варианты подключения, чтобы наши клиенты и, возможно, их клиенты могли получать доступ к сервисам, работающим в нашей сети.

В компании Hetzner мы в целом верим в решения, которыми владеем и можем управлять самостоятельно, а также в наличие базовых элементов, на основе которых можно строить дальнейшие проекты. Сеть, и особенно сетевое подключение для наших облачных сервисов, не является исключением.

Хотя технологии за эти годы изменились, мы всегда отдавали предпочтение решениям, где движущиеся части находятся на хостах, а не сложной и замысловатой физической сетевой инфраструктуре. В результате мы разработали систему таким образом, чтобы физическая сеть обеспечивала стабильное IP-соединение с хостами, а хосты предоставляли сетевые функции более высокого уровня. К ним относятся межсетевые экраны, частные сети и вспомогательные инфраструктурные сервисы.

Запуская эти сервисы и сетевые функции на хостах, мы получаем большую свободу и гибкость при проектировании и создании нашего продукта, и не ограничиваемся тем, что предлагают поставщики оборудования. Таким образом, мы обеспечиваем четкое разделение задач между командами и технологиями и можем ограничить зону поражения одним хостом в случае (большинства) ошибок. Это также означает, что мы можем и должны полностью владеть решением и адаптировать его к нашим потребностям, но это и так заложено в нашей ДНК.

Немного истории
Исторически сложилось так, что компания Hetzner использовала различные технологии для обеспечения связи для своих облачных продуктов.

На начальном этапе, в 2011 году, виртуальные серверы Hetzner vServers использовали жесткие диски, нативные мосты Linux и статические маршруты. Они обеспечивали двухстековое подключение со скоростью до 1 Гбит/с на хост. В итоге, с такой конфигурацией работало около 25 000 экземпляров.

Следующая версия продукта была запущена в сентябре 2015 года с гиперконвергентной конфигурацией на базе Ceph. Она перешла на динамическую маршрутизацию через BGP и конфигурацию моста Linux с использованием NAT 1:1 для IPv4 и полностью маршрутизируемых префиксов IPv6. Это обеспечило лучшую мобильность IP-адресов и обслуживание хостов без влияния на клиентов. В 2016 году каналы связи с хостами были модернизированы до 2 x 10 Гбит/с. Эта конфигурация просуществовала до 2018 года и разрослась примерно до 50 000 экземпляров.

Когда Hetzner Cloud был запущен в 2018 году, мы отказались от NAT и перешли на прямую маршрутизацию IPv4. В июле 2019 года мы представили плоскость данных на основе Open vSwitch и добавили поддержку частных облачных сетей на основе инкапсуляции VXLAN. В ноябре 2020 года мы начали миграцию части публичной сети на Open vSwitch, что позволило нам запустить межсетевые экраны с сохранением состояния на основе потоков Open vSwitch, а в марте 2021 года...netfilter

Составные части хоста виртуальной машины
Мы уже выяснили, что важные части сетевого стека работают на виртуальных машинах; но что они должны предоставлять для функционирования облачного сервера?

Для большинства серверов требуется доступ к Интернету, чтобы система и её сервисы были доступны как из дома, так и из-за рубежа. Некоторые серверы используют частные сети (Private Networks), либо вместо общедоступных сетей, либо совместно с ними, которые соединяют серверы, балансировщики нагрузки и, возможно, выделенные серверы через частную виртуальную сеть, доступ к которой имеют только ваши системы. Трафик частной сети инкапсулируется с помощью виртуальной расширяемой локальной сети (VXLAN) и уникального виртуального идентификатора сети (VNI) для каждой частной сети. Сетевой стек хоста гарантирует, что только участники, подключенные к соответствующей частной сети, могут отправлять или получать трафик.

Для управления доступом к вашим сервисам, доступным из Интернета, мы предлагаем функцию облачного брандмауэра. Она позволяет контролировать доступ к определенным портам или протоколам сервера, а также ограничивать трафик, который может покидать сервер. Это должно происходить как можно ближе к серверу, то есть на хосте. Создание централизованных брандмауэров с отслеживанием состояния потребовало бы дополнительного оборудования и сетевых наложений для передачи «чистого» трафика на серверы и значительно усложнило бы задачу обеспечения высокой доступности и централизованного отслеживания соединений.

По умолчанию образы наших облачных серверов настроены на использование протокола динамической конфигурации хостов (DHCP) для динамической настройки IPv4-адресов и маршрутов. Следовательно, нам необходимо предоставить DHCP-сервер, чтобы серверы могли запрашивать конфигурацию IPv4-сети для общедоступных и частных сетевых интерфейсов.

В большинстве образов используется для настройки некоторых частей системы, например, для настройки сети IPv6, запуска DHCP для частных сетевых интерфейсов, подключения облачных томов и т.д. Для выполнения этих задач необходимо запрашивать информацию о локальной системе или конфигурационных параметрах пользователя с нашего сервера метаданных, доступного по адресу. Кроме того, сервер метаданных используется многими интеграциями, включая, помимо прочего, наш драйвер CSI, hc-utils, инструменты дистрибутивов, такие как Flatcar Linux и, или Talos Linux.cloud-initcloud-init 169.254.169.254/cloud-initAfterburnIgnition

Для обеспечения максимальной отказоустойчивости и доступности, DHCP-сервер и сервер метаданных работают локально на каждом хосте виртуальной машины.

Помимо этих сервисов, доступных пользователям, на виртуальных машинах работает множество внутренних служб, которые обеспечивают бесперебойную работу серверов, получение сетевой информацией для настройки подключения, а также отслеживание происходящего нашей системой мониторинга.

Однако в этой статье мы сосредоточимся на сетевом стеке и более подробно рассмотрим его внутреннее устройство.

Открыть vSwitch
Большая часть передачи сетевых данных осуществляется с помощью Open vSwitch, или сокращенно OVS, многоуровневого виртуального коммутатора с открытым исходным кодом. Его протокол передачи данных уже давно включен в ядро ​​Linux, а пакеты для пользовательского пространства/управляющей плоскости доступны для всех основных дистрибутивов Linux.

Это сетевой стек по умолчанию для некоторых сред виртуализации, и многие готовые решения поддерживают OVS. К ним относятся, помимо прочих, Proxmox VE, Open Stack и oVirt. Однако мы не используем ни одну из этих сред, а управляем KVM и всеми сопутствующими компонентами с помощью собственных инструментов.

Open vSwitch — это универсальное сетевое решение, предлагающее множество функций, часть из которых мы используем в наших примерах и для настройки. Оно использует OpenFlow, открытый протокол, созданный для настройки плоскости данных сетевых устройств и определения способа пересылки пакетов. Для каждого направления связи должен существовать поток, определяющий, как должны обрабатываться пакеты и куда их необходимо отправлять.

Это могут быть точные совпадения, например, для связи со шлюзом через ARP, NDP, ICMP и т. д., трафика, предназначенного для других участников частной сети, или подключений к сервису в Интернете.

Открытая оркестрация vSwitch — Flusskrebs
Для обеспечения сетевого подключения наших серверов и балансировщиков нагрузки, а также для настройки любых межсетевых экранов, применяемых к серверу, нам необходимо установить необходимые потоки для Open vSwitch, чтобы обеспечить эти соединения и функции.

Распространенным решением для оркестрации Open vSwitch является проект Open Virtual Network (OVN) control plane, который был запущен одновременно с самим OVS и предназначен для обслуживания парка узлов, работающих под управлением Open vSwitch. Он предоставляет уровень абстракции, где можно настраивать логические маршруты и коммутаторы, которые затем преобразуются в OpenFlow.

Когда Open vSwitch был внедрен в стек Hetzner Cloud, мы решили не идти по этому пути и вместо этого разработали собственное решение под названием Flusskrebs (буквально переводится как «речной краб» или «потоковый краб»). Оно написано на Python, предоставляет REST API, используемый локальной частью нашей плоскости управления облаком, и настраивает потоки, необходимые каждой виртуальной машине или балансировщику нагрузки для корректной работы. Это включает в себя потоки для реализации любых правил брандмауэра, настроенных пользователем или нашим бэкэндом, например, для блокировки исходящего SMTP по умолчанию.

Контроллер также выступает в качестве центрального DHCP-сервера для частных сетевых интерфейсов на каждом хосте.

Сетевой стек хоста виртуальной машины
Учитывая общие архитектурные принципы и эти базовые элементы, давайте подробнее рассмотрим сетевой стек нашего хоста виртуальной машины. На следующем рисунке представлен упрощенный обзор внутренней работы сетевого стека хоста виртуальной машины.
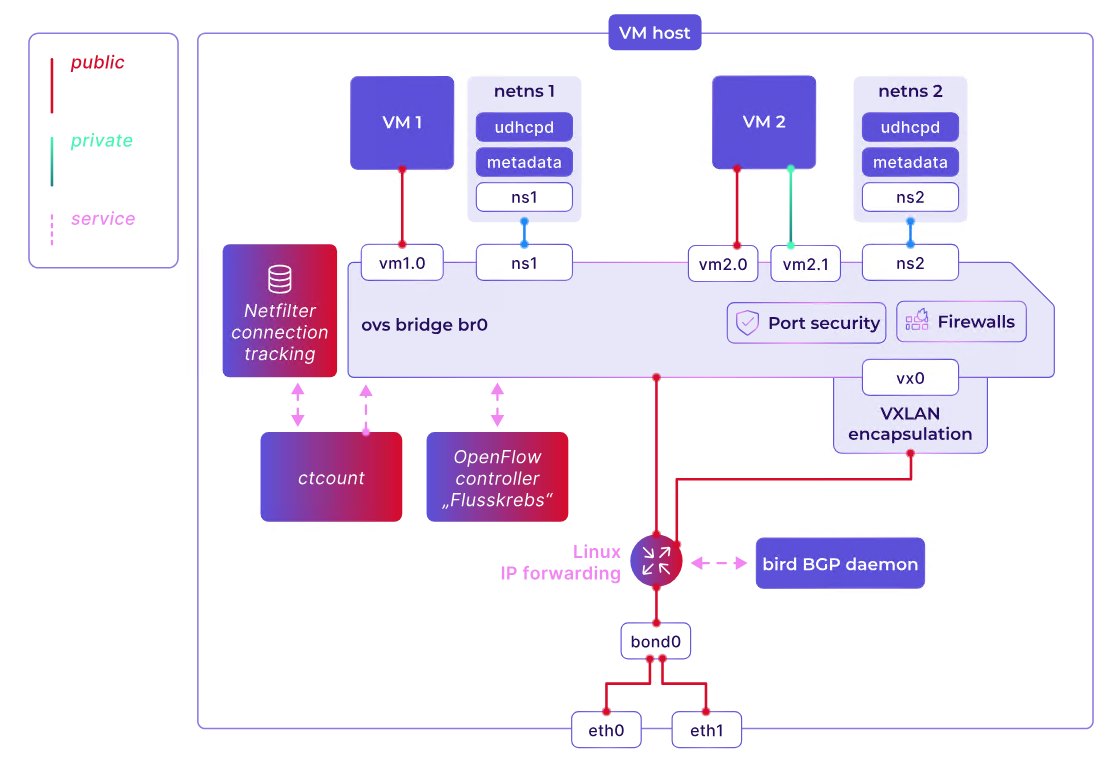


Большинство хостов используют два восходящих интерфейса 10 Гбит/с, объединенных в группу агрегации каналов (LAG) или, в Linux, с использованием LACP, подключенных к двум физическим коммутаторам, образующим виртуальное шасси для повышения отказоустойчивости и пропускной способности. Для дальнейшего повышения отказоустойчивости в начале этого года мы начали переход на два маршрутизируемых восходящих канала с использованием BGP, подключенных к двум независимым коммутаторам. Следует отметить, что восходящие интерфейсы не подключены напрямую к мосту OVS, но система Linux осуществляет маршрутизацию между восходящими каналами и OVS. Таким образом, доступность хоста не зависит от OVS, что упрощает установку и обслуживание хоста.bond

Центральный мост Open vSwitch выступает в качестве основного компонента, обеспечивающего сетевое подключение и функции, и все облачные серверы на хосте подключены к нему. Каждый сервер может иметь один публичный сетевой интерфейс, а также до трех частных сетевых интерфейсов. Для отображения потоков, обеспечивающих исходящий трафик с сервера в сеть, используются следующие шаблоны:

# Only process packets with correct source MAC address
table=0, priority=9999, in_port={vm_port_no}, eth_src={mac}, actions=set_field:1->reg0,set_field:{vm_port_no}->reg5,resubmit(,1)
# Only accept packets with an IPv4/IPv6 address associated with the server
table=3, priority=9999, in_port={vm_port_no}, ip_src={ip}, ip, actions=resubmit(,4)
table=3, priority=9999, in_port={vm_port_no}, ipv6_src={ip}/64, ipv6, actions=resubmit(,4)
table=3, priority=9999, in_port={vm_port_no}, arp, arp_op=2, arp_spa={ip}, actions=resubmit(,4)


Входящий трафик к серверу перенаправляется с использованием следующих потоков, по одному для каждого префикса IPv4 или IPv6 соответственно. Сетевой стек хоста идентифицирует себя для виртуальной машины, используя общеизвестный «MAC-адрес виртуального шлюза», который всегда равен .d2:74:7f:6e:37:e3

table=22, priority=9999, in_port={internet_port_no}, ip, ip_dst={ip}, actions=mod_dl_src:d2:74:7f:6e:37:e3,{vm_port_no}
table=22, priority=9999, in_port={internet_port_no}, ipv6, ipv6_dst={ip}/64, actions=mod_dl_src:d2:74:7f:6e:37:e3,{vm_port_no}


Инфраструктурные сервисы, такие как DHCP и серверы метаданных, также подключены к Open vSwitch и работают параллельно с каждым сервером в выделенном пространстве имен Linux для каждого сервера.

Обратите внимание, что DHCP-сервер, показанный на рисунке выше, отвечает только за публичные интерфейсы любого сервера. Как описано выше, контроллер Flusskrebs содержит центральный DHCP-сервер, обрабатывающий все частные сетевые интерфейсы. Процесс подключения к публичному DHCP-серверу также прост:udhcpd

table=1, priority=9999, in_port={vm_port_no}, udp, udp_dst=67, actions={service_port_no}
table=1, priority=9999, in_port={service_port_no}, udp, udp_src=67, actions={vm_port_no}


Наряду с Open vSwitch, для реализации функции межсетевого экрана с сохранением состояния используется отслеживание соединений Linux netfilter. При наличии глобальной общей таблицы отслеживания соединений необходимо предотвратить ее переполнение и обеспечить справедливое использование для всех серверов и клиентов. Это достигается с помощью другого внутреннего проекта, который отслеживает записи отслеживания соединений и устанавливает ограничение в 80 000 активных одновременных соединений на сервер. Если сервер достигает этого лимита, новые соединения не могут быть открыты до тех пор, пока не будет закрыто предыдущее.ctcount

Статус-кво
Эта платформа обработки данных на базе Open vSwitch хорошо нам служила и в основном продолжает служить до сих пор, даже при наличии более миллиона облачных серверов. Однако мы достигли некоторых ограничений и хотели улучшить масштабируемость, отказоустойчивость и гибкость с помощью более специализированного сетевого стека. В течение последних лет наша команда SDN разрабатывала именно такое решение, адаптированное к нашим потребностям, простое в эксплуатации и являющееся прочной основой для новых функций, таких как IPv6 для частных сетей.

В следующей части этой серии мы расскажем о следующих этапах нашего пути, о нашей новейшей полностью самостоятельно разработанной сетевой архитектуре и о том, как она работает. Так что оставайтесь с нами!
Новый сервер Hetzner GPU GEX63: еще больше возможностей для ваших рабочих процессов в области искусственного интеллекта


Новый сервер GPU GEX63 для профессиональных задач искусственного интеллекта
В новой модели GEX63 компания Hetzner предлагает сервер с графическим процессором NVIDIA RTX PRO 6000 Blackwell Max-Q и 96 ГБ видеопамяти GDDR7 ECC.

Сервер предназначен для профессиональных задач, таких как вывод результатов работы ИИ, тонкая настройка и обучение ИИ, а также подходит для ресурсоемких вычислительных задач в областях рендеринга, моделирования, обработки изображений и речи.

Он оснащен процессором Intel Core Ultra 7 265 «Arrow Lake» с 20 ядрами. Также в комплект входят 128 ГБ оперативной памяти DDR5 UDIMM и два твердотельных накопителя NVMe Datacenter Edition (Gen4) объемом 1,92 ТБ каждый.

Таким образом, GEX63 сочетает в себе высокую производительность графического процессора с оптимизированной для него конфигурацией по привлекательной цене. GEX63 доступен по цене 999,00 евро / 1199,00 долларов США в месяц, включая IPv4-адрес, плюс единовременный сбор за подключение в размере 999,00 евро / 1199,00 долларов США.
www.hetzner.com/dedicated-rootserver/gex63/

НОВЫЙ ОБЛАЧНЫЙ СЕРВЕР. НИЗКАЯ ЦЕНА.
Для расширения ассортимента наших экономичных облачных серверов мы представили сервер CPX02 «Regular Performance» с 1 виртуальным процессором, 1 ГБ оперативной памяти и 20 ГБ хранилища, который теперь доступен в наших европейских центрах обработки данных (FSN1, HEL1 и NBG1), а также в Сингапуре (SIN1).

Этот сервер особенно подходит для приложений с очень низким потреблением ресурсов и минимальными системными требованиями, таких как статические веб-сайты, блоги или простые веб-приложения с одним сервисом.

Облачный сервер CPX02 доступен по цене от 5,99 евро / 7,49 долларов США в месяц.
www.hetzner.com/cloud/regular-performance

НОВАЯ ФУНКЦИЯ ОТПРАВКИ ЭЛЕКТРОННЫХ ПИСЕМ ДЛЯ УПРАВЛЯЕМЫХ ПРОДУКТОВ
В настоящее время мы постепенно обновляем все наши серверы веб-хостинга и управляемые серверы с Debian Bookworm до Debian Trixie. В рамках этого обновления программного обеспечения мы обновляем не только версию Debian, но и другое программное обеспечение, которым мы управляем.

В этом обновлении вам также станет доступна новая функция электронной почты: учетные записи электронной почты будут поддерживать так называемую «дополнительную адресацию» (субадресацию). Это позволит вам использовать субадреса в формате « emailaccount+subaddress@domain.de ». Письма, отправленные на такой субадрес, будут автоматически доставляться в соответствующий почтовый ящик « emailaccount@domain.de ». Например, вы можете использовать отдельные субадреса для рассылок, регистрации или интернет-магазинов, не создавая дополнительных почтовых ящиков.

Важно: если в настоящее время вы используете почтовый ящик для всех писем в подобных сценариях, электронные письма, отправленные на эти подадреса, будут доставляться непосредственно в соответствующий почтовый ящик, а не в почтовый ящик для всех писем. Это произойдет после миграции вашего сервера на Debian Trixie.
docs.hetzner.com/managed/general/softwareupdates/#softwareupdates-2026

HETZNER — ЛУЧШИЙ ПРОВАЙДЕР ВЕБ-ХОСТИНГА ДЛЯ БИЗНЕСА 2026 ГОДА
Восемь провайдеров, четыре недели непрерывного нагрузочного тестирования, более миллиона точек данных: IT-журнал Connect Professional протестировал продукты веб-хостинга известных хостинг-провайдеров на стабильность, веб-сервисы и производительность серверов.

Наш пакет «Webhosting S» занял первое место с оценкой «отлично». Это также самый доступный продукт в тесте: «Хотя цена не играет роли в нашей оценке, всё же примечательно, что самый доступный продукт в сравнении уверенно занял первое место в тесте», — пишет connect professional. Подробный отчет о тестировании на немецком языке можно найти здесь.
www.hetzner.com/webhosting/


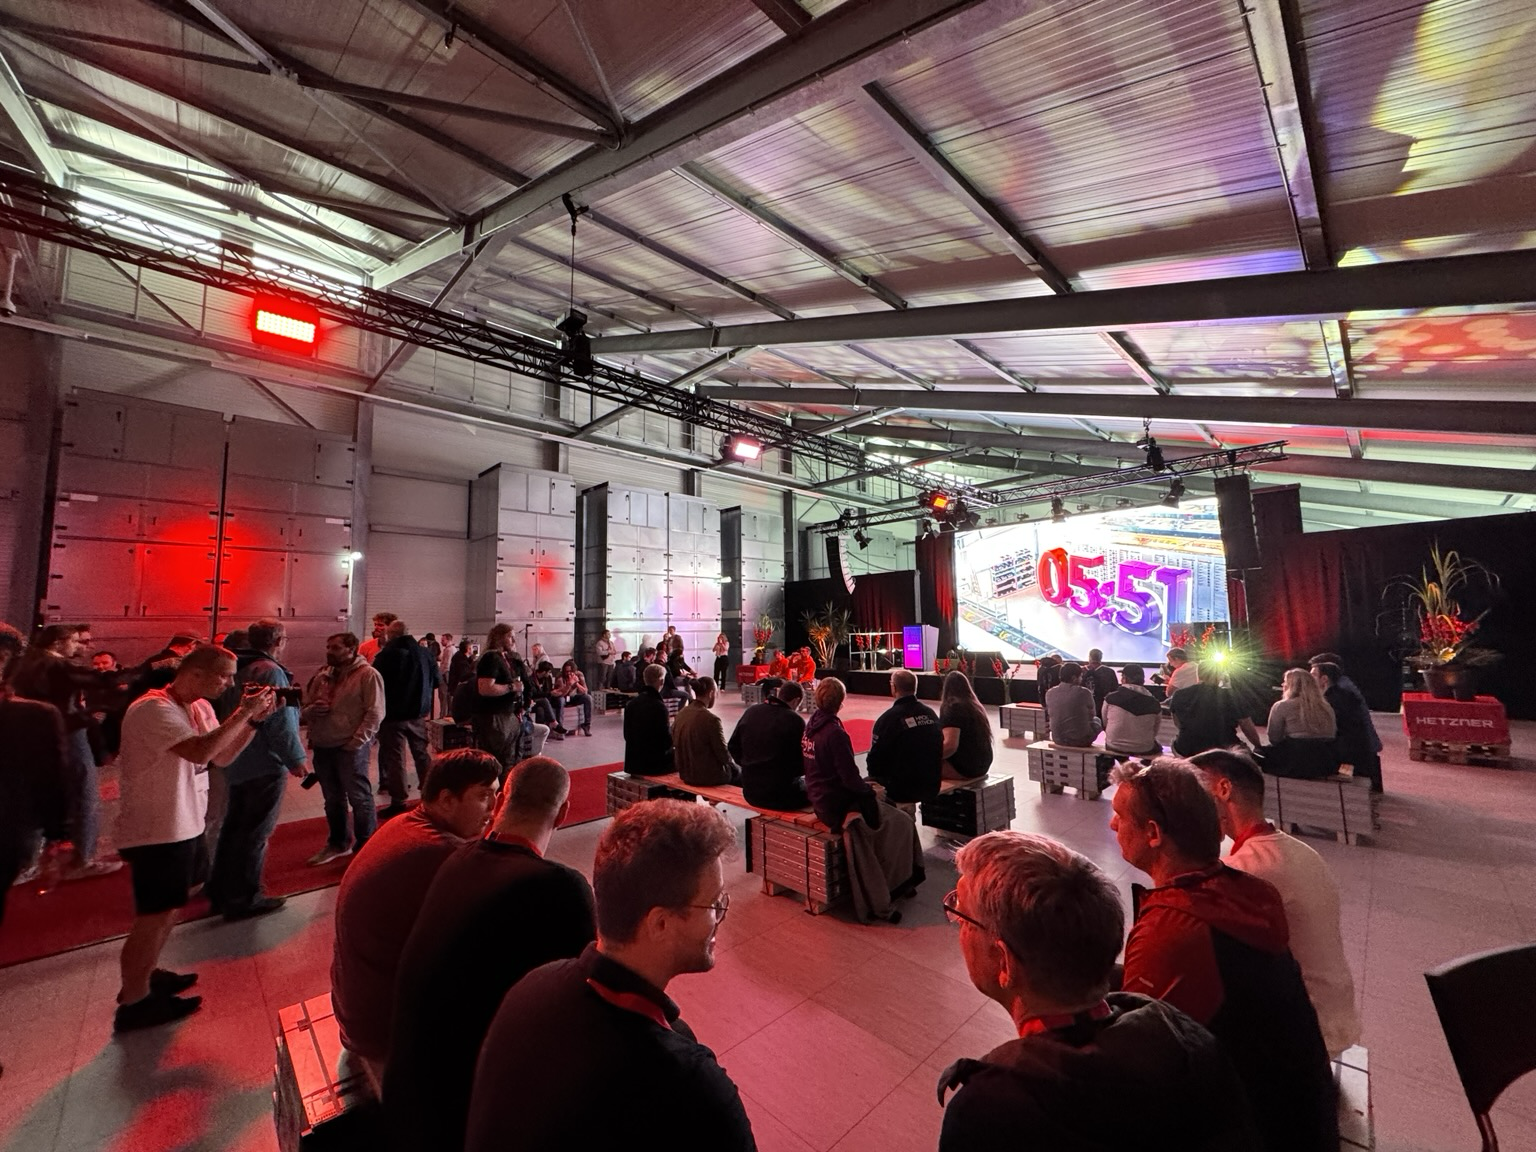
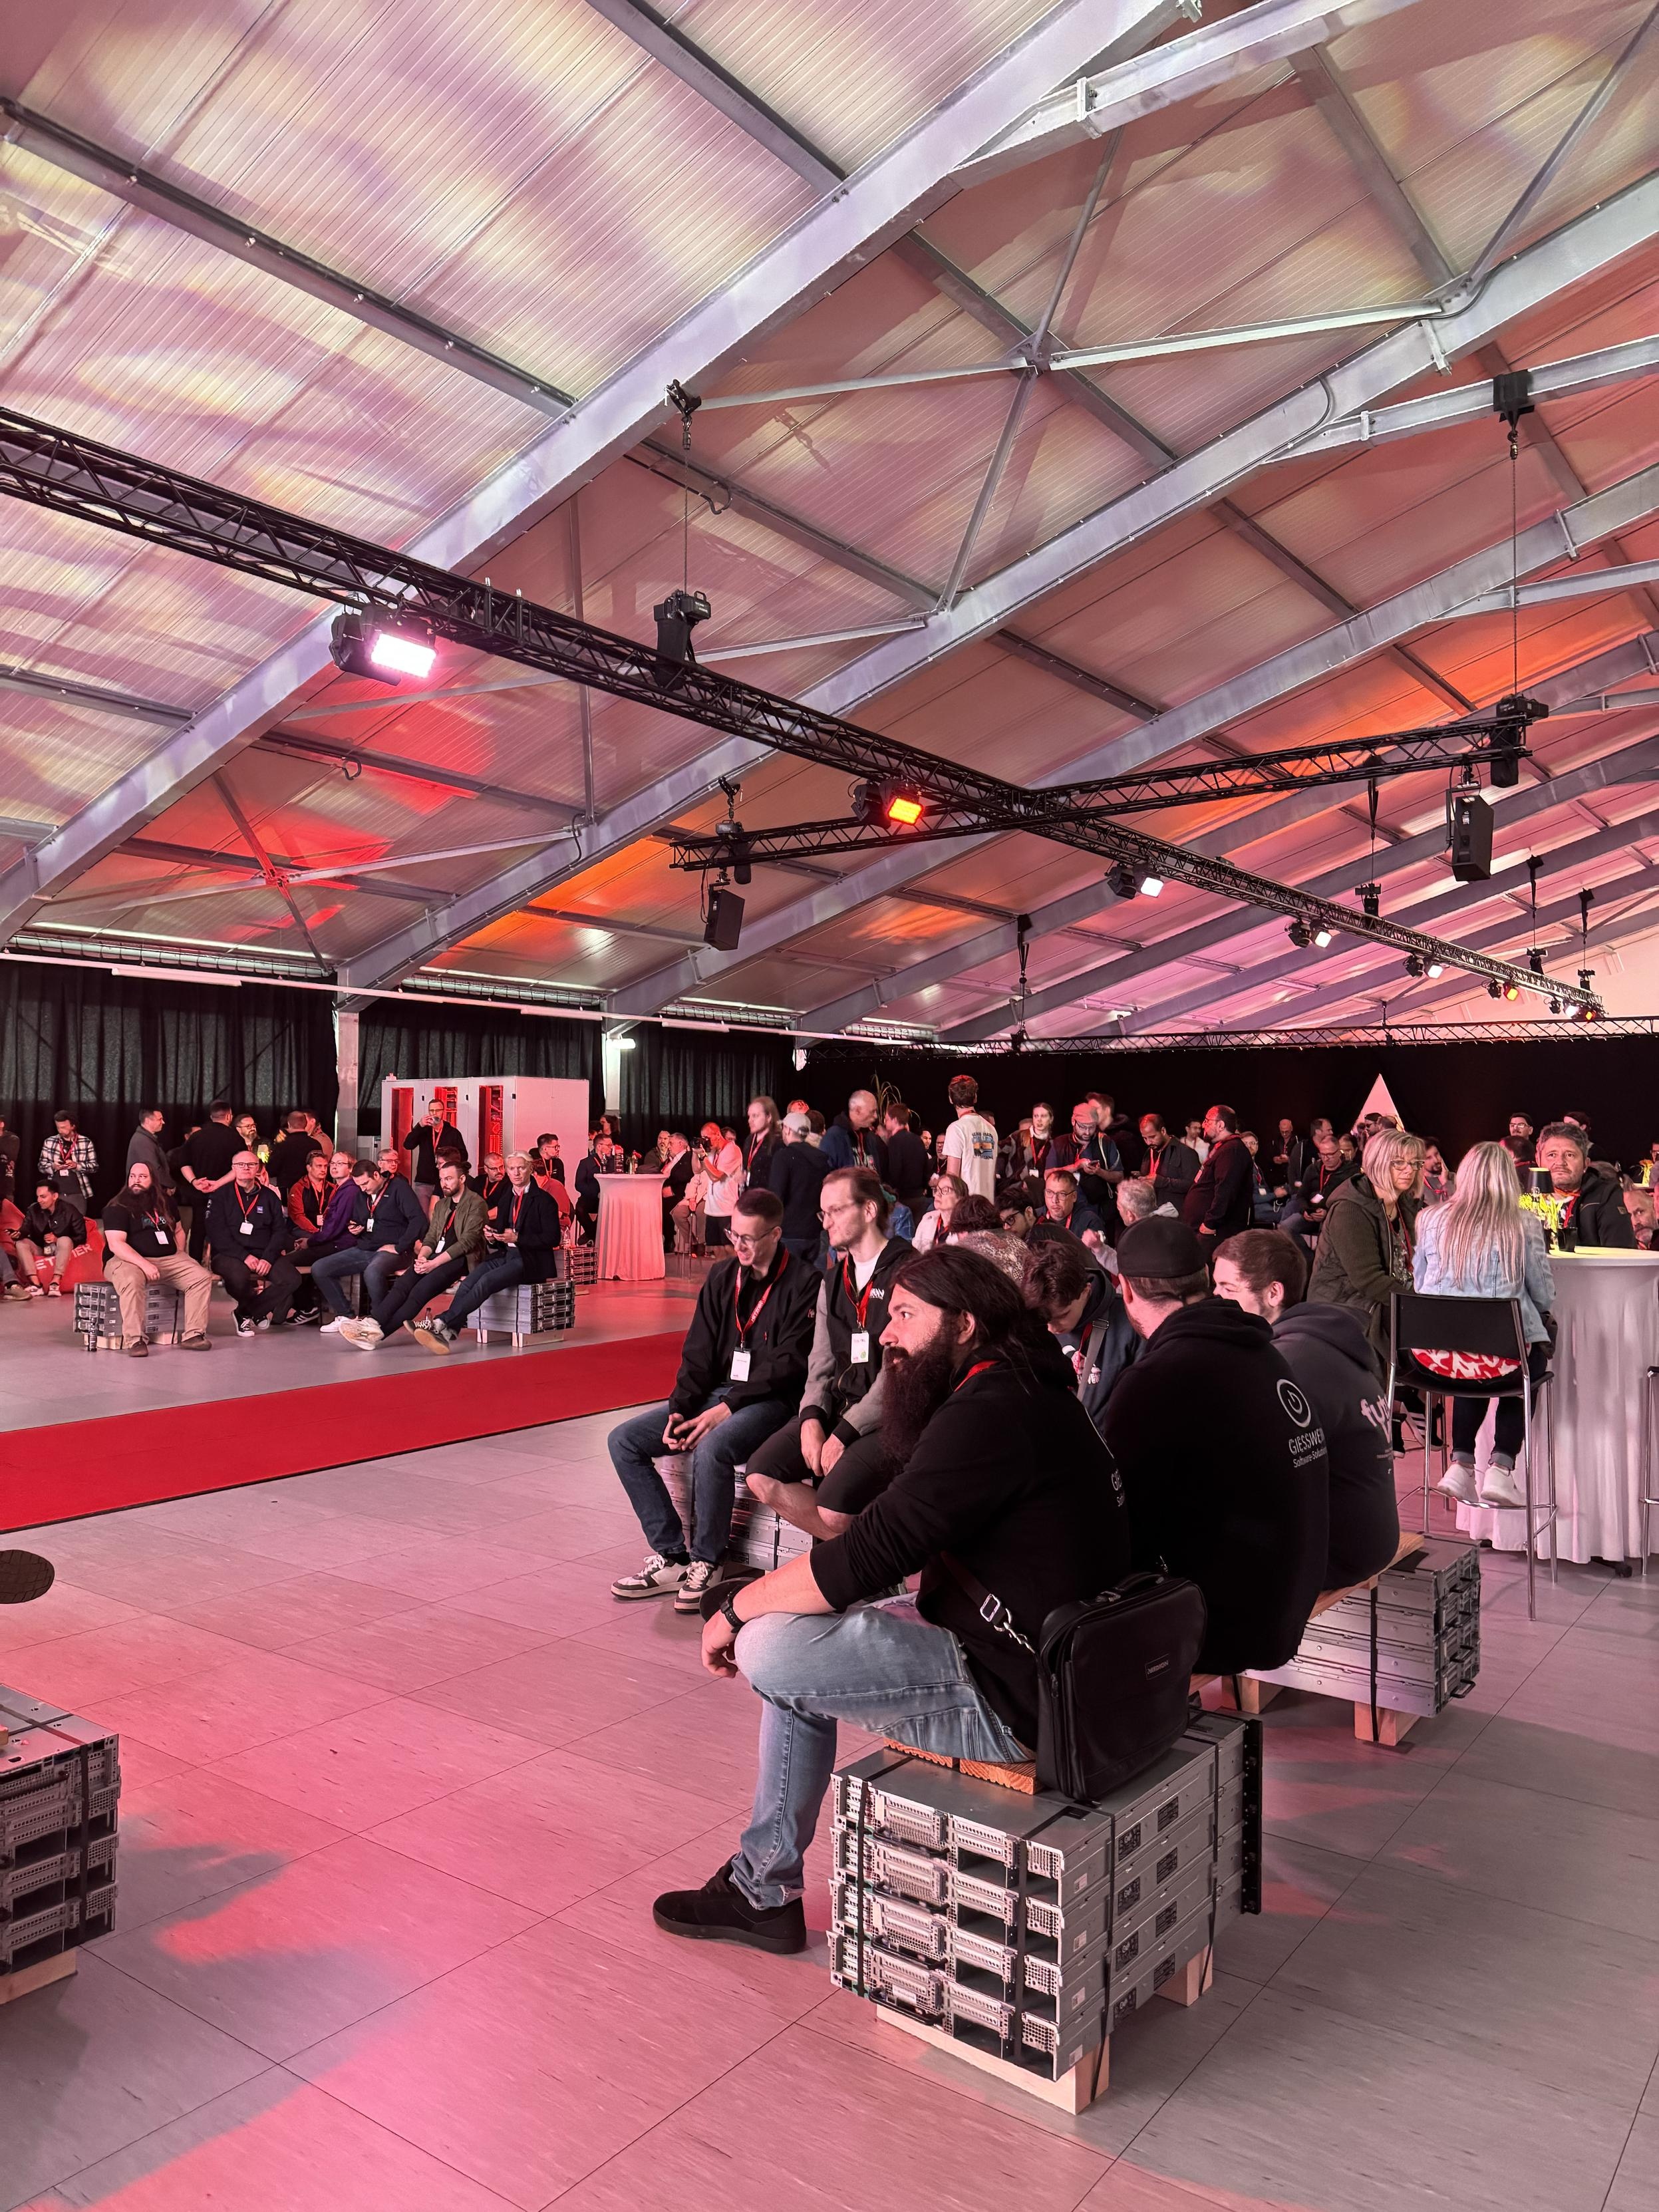
Это был саммит Хетцнера 2026 года.
Технологии, связи и взгляд из-за кулис: 17 сентября 2026 года в нашем крупнейшем центре обработки данных в Фалькенштайне (Германия) состоялся второй саммит Hetzner.

В ходе различных сессий обсуждались актуальные темы из мира Hetzner и технологий. Во время экскурсий по нашим центрам обработки данных и различным экспозициям гости также могли вблизи ознакомиться с нашей инфраструктурой и продукцией.

Этот день был особенно насыщен личными встречами, новыми идеями и множеством интересных разговоров. Большое спасибо всем, кто присутствовал и помог организовать саммит.

Для тех, кто не смог присутствовать лично, мы собрали основные моменты на сайте саммита. Записи презентаций также будут постепенно размещаться там.
www.hetzner.com/hetzner-summit/


Церемония закладки первого камня нового кампуса Хетцнер.
Для нас это особый момент и важная веха: церемония закладки первого камня нового кампуса Hetzner в Гунценхаузене знаменует начало масштабного проекта.

К началу 2030 года мы построим новую штаб-квартиру, рассчитанную на более чем 500 сотрудников, на территории компании площадью 70 000 квадратных метров.

Таким образом, мы создаём пространство для дальнейшего роста и для множества новых идей, оставаясь при этом тесно связанными с Гунценхаузеном.
www.hetzner.com/pressroom/hetzner-celebrates-groundbreaking-for-new-corporate-headquarters-in-gunzenhausen/

Компания Hetzner отметила начало строительства своей новой корпоративной штаб-квартиры в Гунценхаузене


Компания Hetzner Online, поставщик услуг хостинга и облачных решений, основанная в Гунценхаузене в 1997 году, сегодня отметила важную веху в своем дальнейшем развитии: состоялась официальная церемония закладки первого камня, ознаменовавшая начало строительства нового кампуса Hetzner в индустриальном парке Nord в Гунценхаузене, Германия.

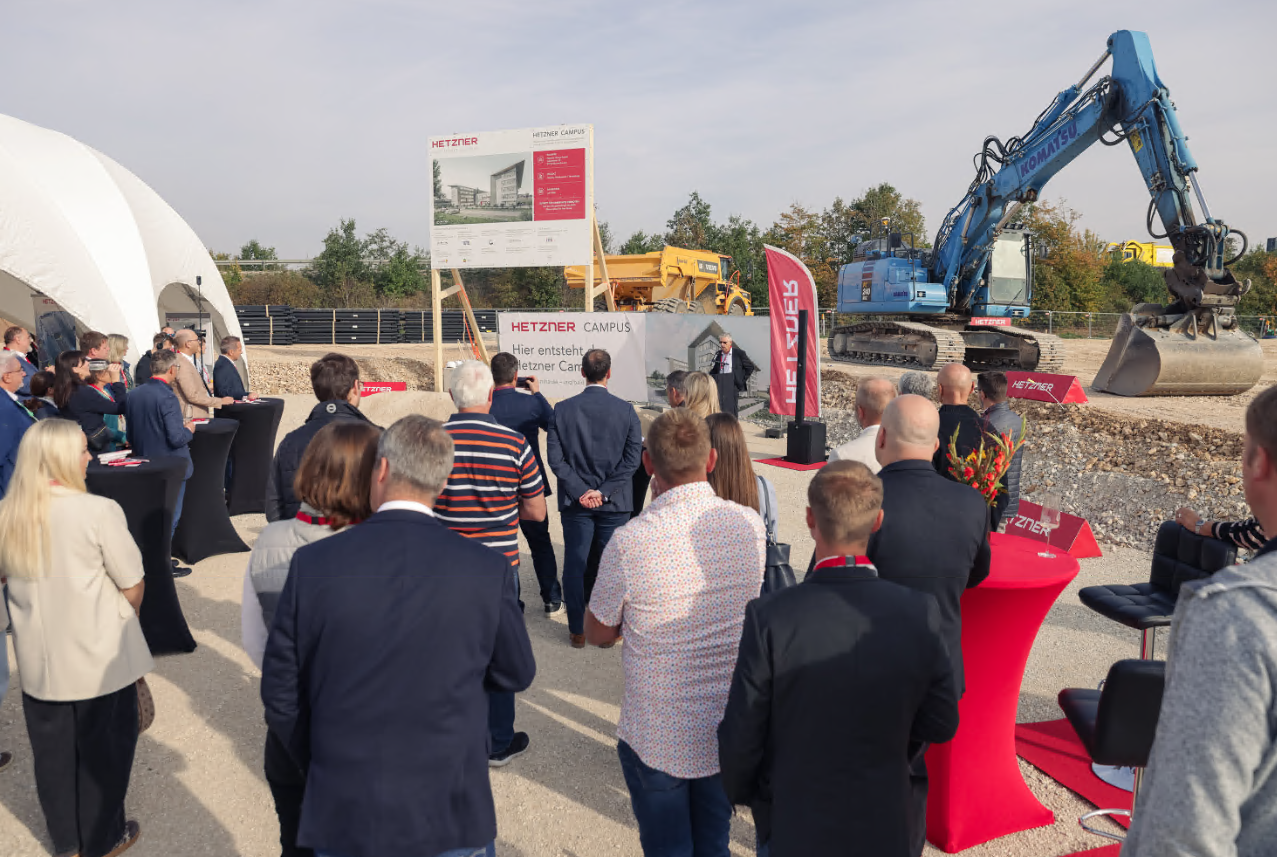
Компания Hetzner приветствовала главу районной администрации Маркуса Глезера, мэра Маттиаса Хёрра, представителей городского совета и агентства экономического развития, а также архитекторов, специалистов по планированию и строительные компании, участвующие в проекте, на официальной церемонии закладки первого камня. Гости вместе отметили начало строительного проекта, который компания Hetzner более подробно представила во время мероприятия.

Новый кампус Hetzner будет построен в ближайшие годы на участке земли площадью приблизительно 70 000 квадратных метров. Площадь здания составит 13 500 квадратных метров, и оно рассчитано на размещение более 500 сотрудников.

Уникальной особенностью здания является его архитектура: кампус проектируется в форме буквы «H» для компании Hetzner. Первоначально будет полностью застроено одно из крыльев здания. Остальные помещения обеспечат дополнительные мощности для будущего роста компании.

Новый кампус предназначен не только для предоставления дополнительных офисных помещений. Планируется создание многочисленных зон для сотрудничества, взаимодействия и отдыха. К ним относятся несколько центральных мест для встреч в виде так называемых «рынков» с кофейными барами или мини-кухнями и неформальными переговорными зонами, ресторан, терраса на крыше и фитнес-центр. Кроме того, предусмотрено место для присмотра за детьми во время каникул, демонстрационный зал техники Hetzner, игровая комната, учебный зал и кабинет физиотерапии. Четыре гостиничных номера будут доступны сотрудникам из других офисов Hetzner во время их пребывания в Гунценхаузене.

Создавая этот кампус, компания Hetzner формирует дополнительные пространства для дальнейшего роста и современных рабочих мест. В то же время компания подчеркивает свою долгосрочную приверженность Гунценхаузену как деловому центру.

«Создавая новый кампус, мы закладываем основу для дальнейшего роста в ближайшие годы. В то же время, эти инвестиции являются явным подтверждением приверженности Гунценхаузену и нашему долгосрочному развитию в этом регионе», — поясняет Гюнтер Мюллер, генеральный директор Hetzner Online.

Строительные работы на новом кампусе уже начались. «Завершение строительных работ планируется к февралю 2027 года. Непосредственно после этого начнутся работы по возведению несущих конструкций. Открытие нового кампуса Hetzner запланировано на начало 2030 года», — добавляет представитель компании Кристиан Фитц.


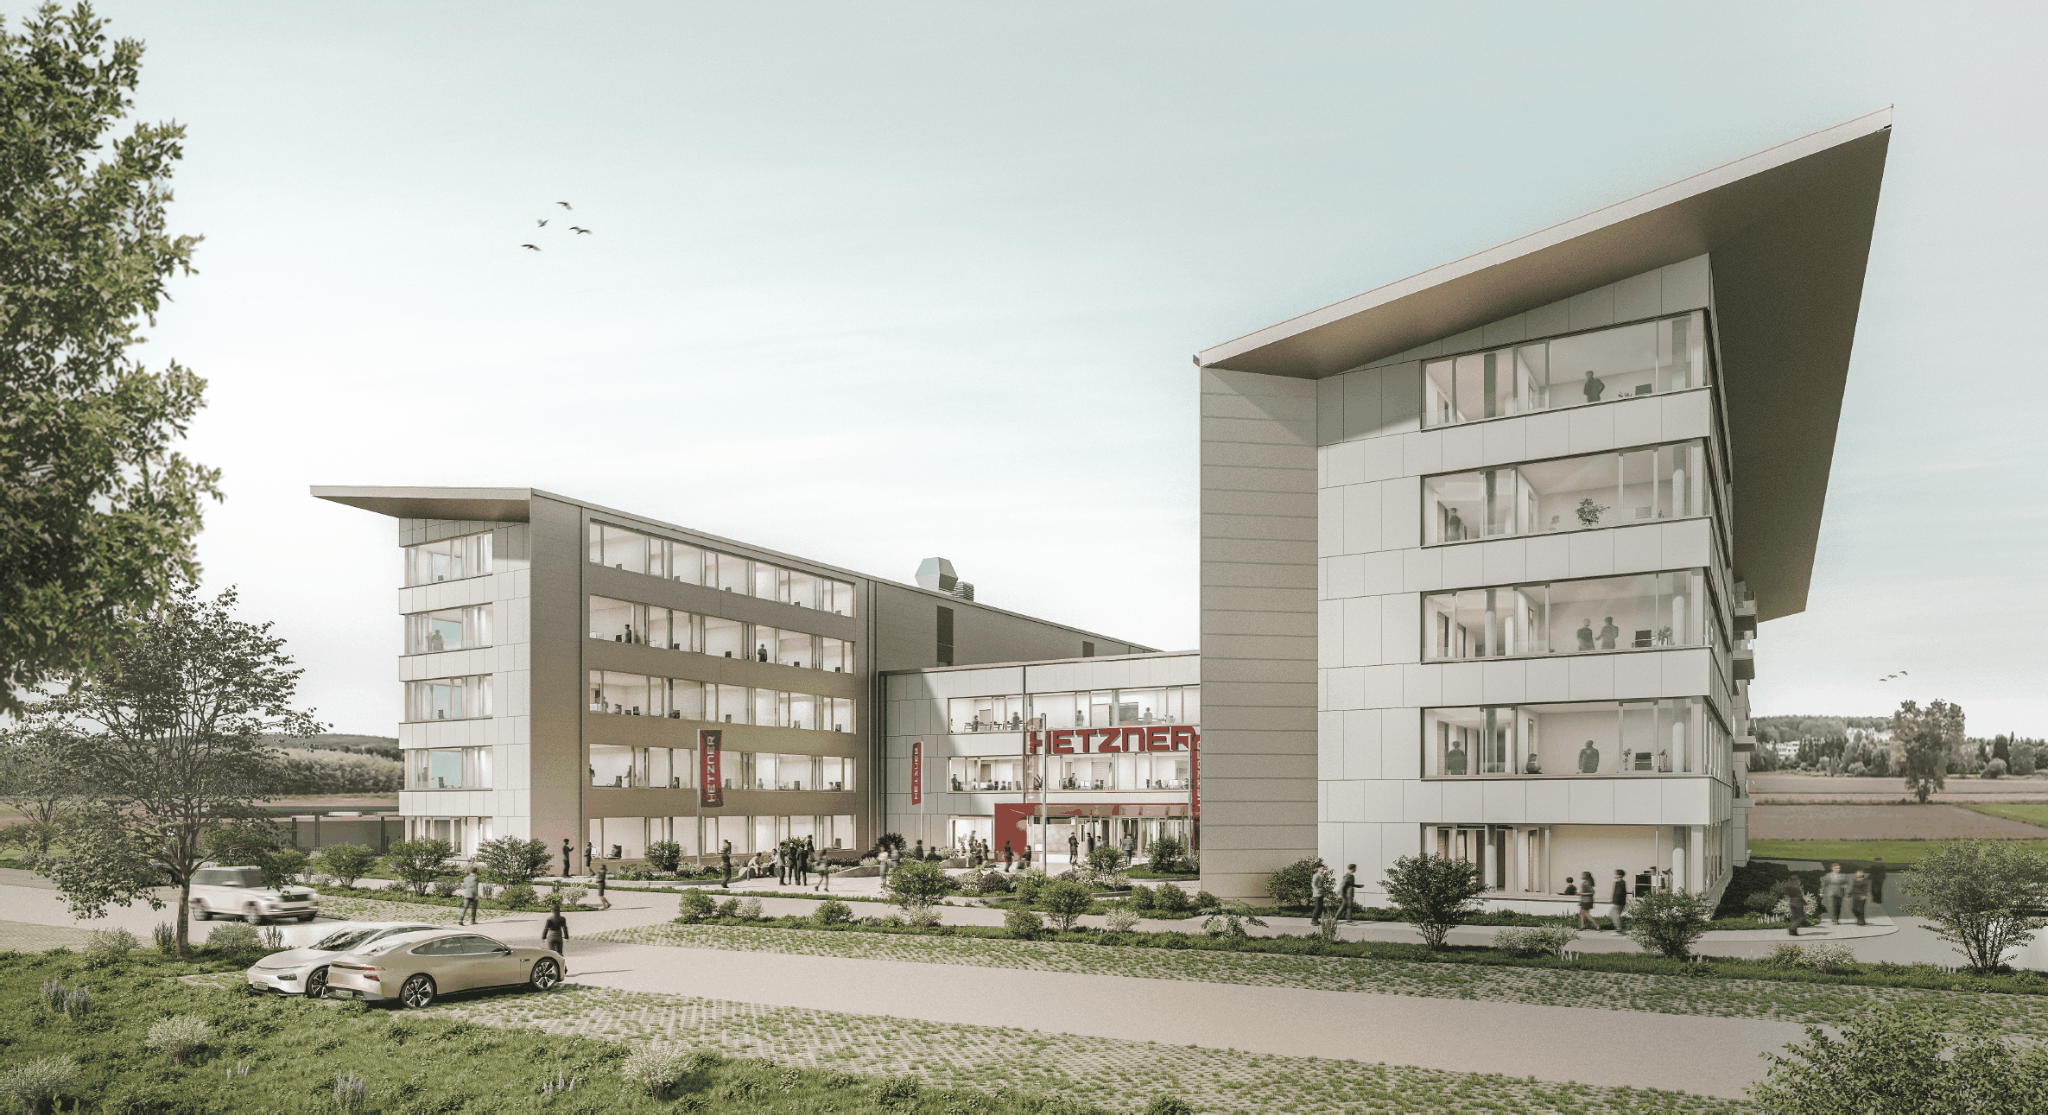
Кампус Hetzner — Так будет выглядеть новая штаб-квартира компании (Фото: Wenzel Architekten+Ingenieure)

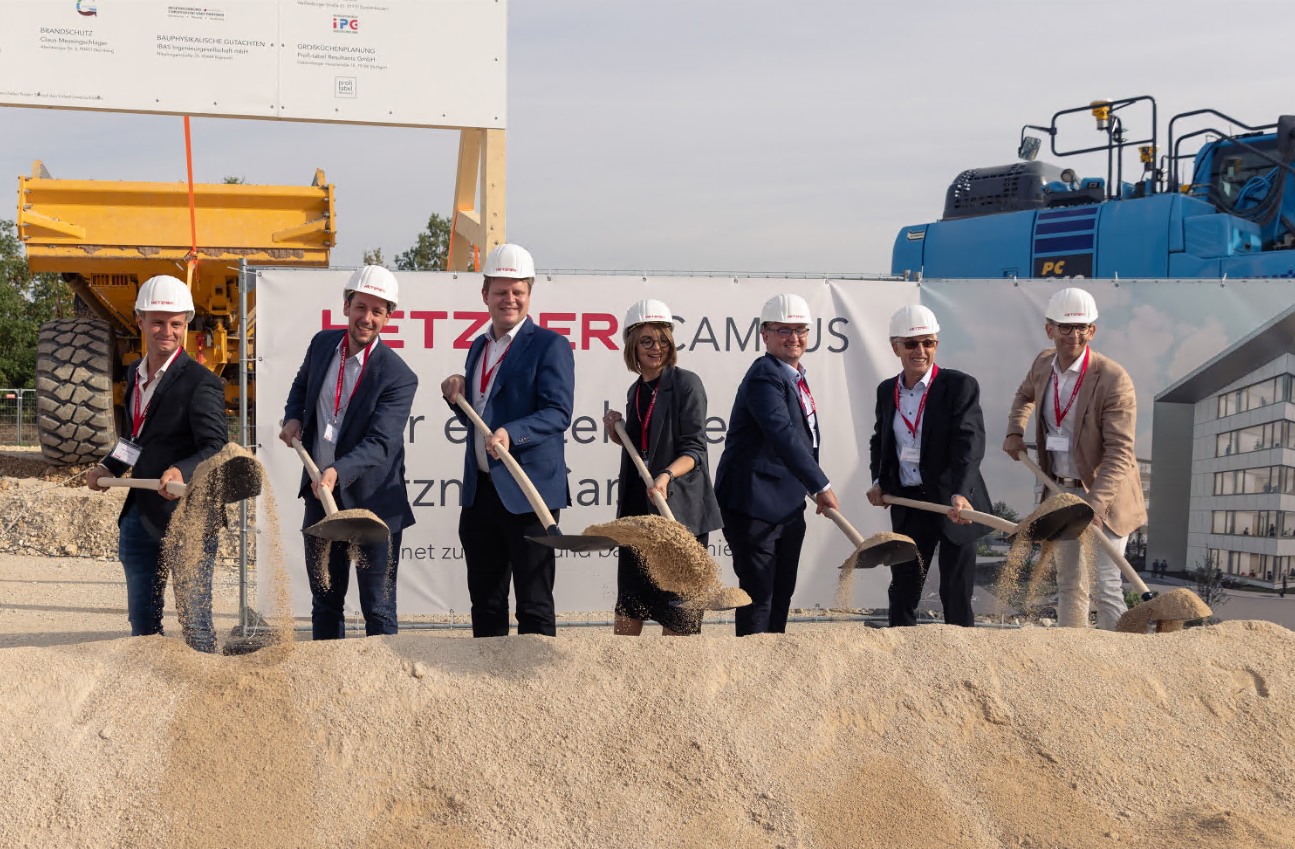
Изображение на заголовке: Штеффен Грилленбергер (Grillenberger Tief- und Straßenbau GmbH), мэр Матиас Хёрр, окружной администратор Маркус Глезер, Хелен Венцель-Йорг (Wenzel Architects+Engineers), Кристиан Солер Альварадо (Hetzner), Гюнтер Мюллер (Hetzner) и Стефан Конвичкова (Hetzner) провели символическую церемонию закладки фундамента нового предприятия. штаб (слева направо).

Изменение среднего напряжения в FSN1


Замена компонентов электропитания на подстанции / изменение среднего напряжения в FSN1
Затронутые системы: FSN1
  • FSN1-DC3
  • FSN1-DC1
  • FSN1-DC2
  • FSN1-DC4
  • FSN1-DC5
  • FSN1-DC6
  • FSN1-DC7
  • FSN1-DC8
  • FSN1-DC9
  • FSN1-DC10
  • FSN1-DC12
  • FSN1-DC14
  • FSN1-DC16
  • FSN1-DC15
  • FSN1-DC13
  • FSN1-DC11
  • FSN1-DC17
  • FSN1-DC18
  • FSN1-DC20
  • FSN1-DC19
  • FSN1-DC22
  • FSN1-DC23
  • FSN1-DC24

В это время технические специалисты будут модернизировать различные компоненты электропитания на подстанции рядом с нашим местоположением в FSN1. Речь идёт о переходе на среднее напряжение с 10 кВ на 20 кВ. Работы не должны негативно повлиять на работу наших серверных систем.

Вы можете узнать, в каком центре обработки данных находится ваш сервер, выполнив трассировку маршрута например, с помощью dnstools.ws

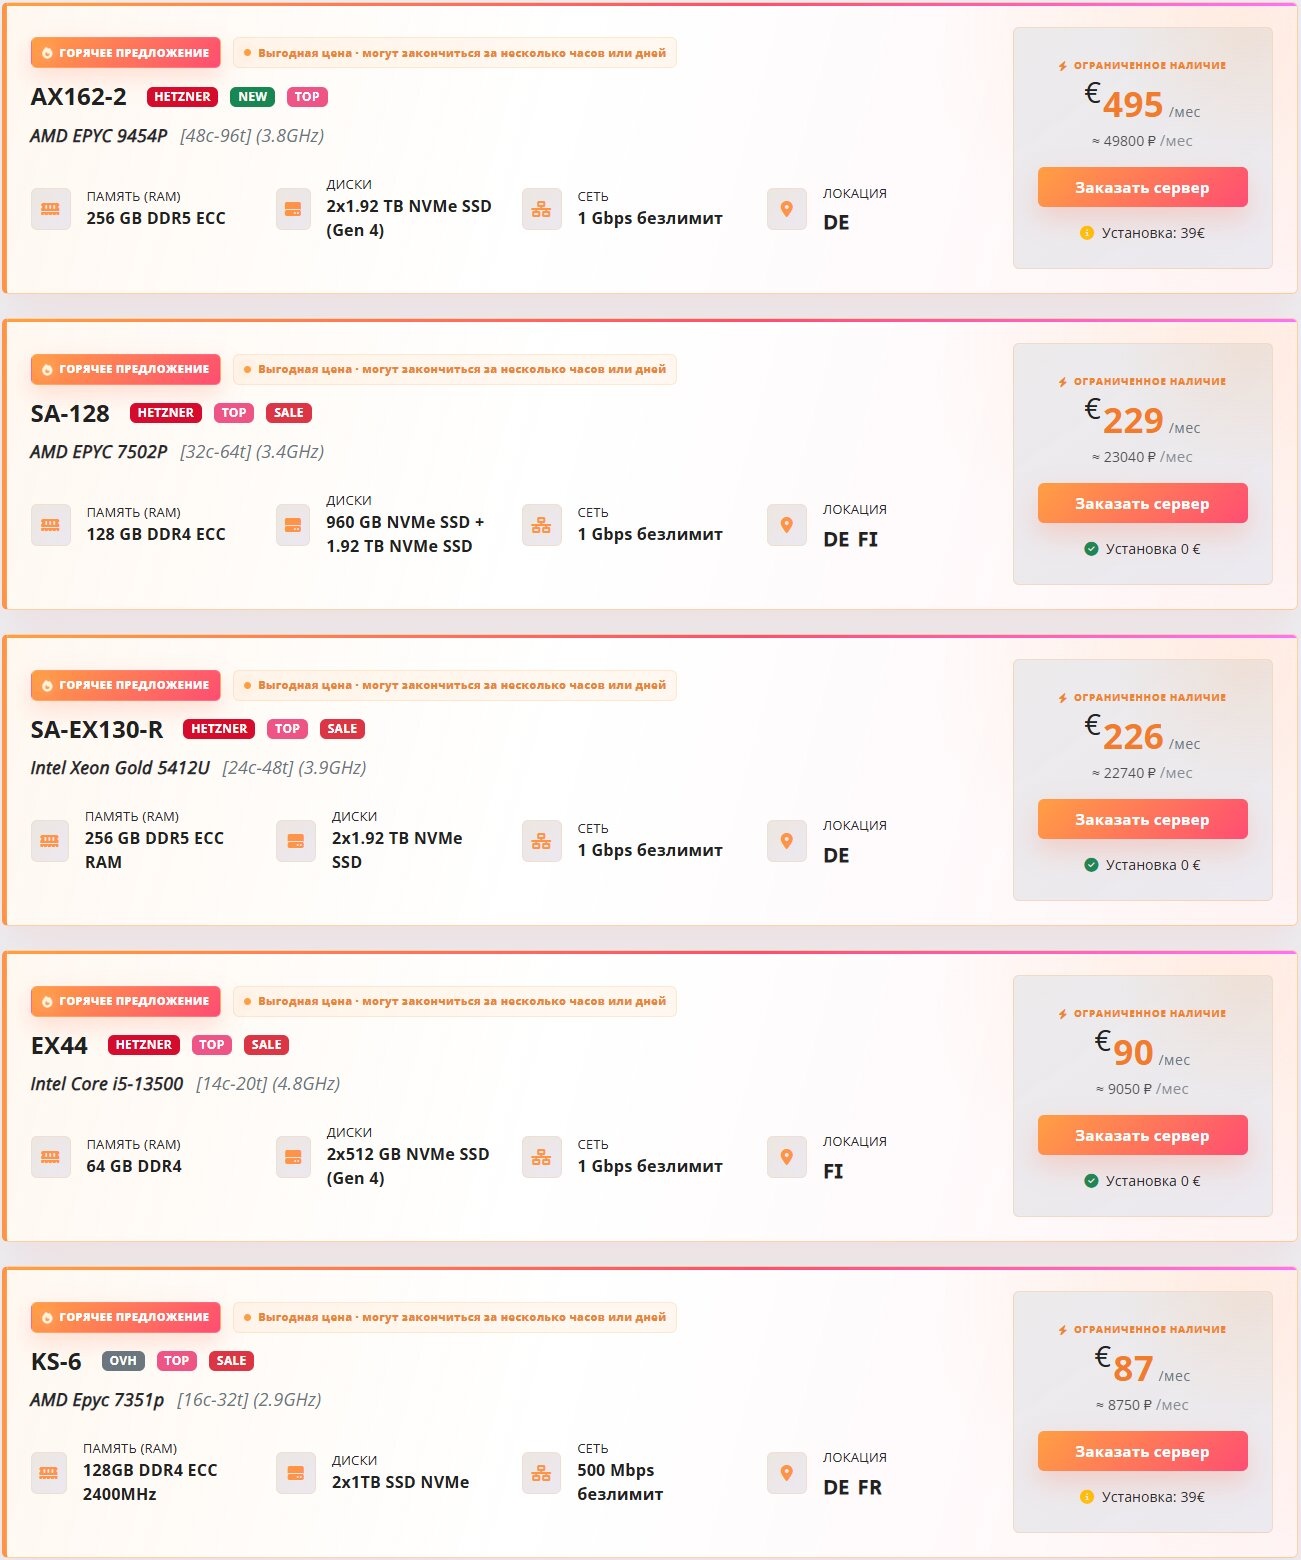
Серверный радар ABCD.HOST #5 — Hetzner и OVH от 87 €/мес


Обновили актуальное наличие выделенных серверов Hetzner и OVH в Европе. Сейчас есть несколько особенно интересных вариантов по цене/характеристикам:

  • DE, FR / AMD EPYC 7351P [16c-32t] / 128 GB ECC / 2×1 TB NVMe / 500 Mbps — 87 €/мес ≈ 8 750 ₽/мес, установка 39 € ≈ 3 920 ₽
  • FI / Intel Core i5-13500 [14c-20t] / 64 GB RAM / 2×512 GB NVMe Gen4 / 1 Gbps — 90 €/мес ≈ 9 050 ₽/мес, установка 0 €
  • DE / Intel Xeon Gold 5412U [24c-48t] / 256 GB DDR5 ECC / 2×1.92 TB NVMe / 1 Gbps — 226 €/мес ≈ 22 740 ₽/мес, установка 0 €
  • DE, FI / AMD EPYC 7502P [32c-64t] / 128 GB ECC / 960 GB + 1.92 TB NVMe / 1 Gbps — 229 €/мес ≈ 23 040 ₽/мес, установка 0 €
  • DE / AMD EPYC 9454P [48c-96t] / 256 GB DDR5 ECC / 2×1.92 TB NVMe Gen4 / 1 Gbps — 495 €/мес ≈ 49 800 ₽/мес, установка 39 € ≈ 3 920 ₽

Безлимитный трафик, защита от DDoS, панель управления сервером.

Бюджетные варианты сейчас особенно интересны: EPYC 7351P с 128 GB за 87 € и i5-13500 за 90 €. Для виртуализации и более серьёзных нагрузок есть EPYC и Xeon с 128–256 GB RAM.

Количество серверов ограничено, наличие может меняться в течение дня.

Актуальное наличие и заказ горячих предложений: abcd.host/dedicated
Быстрая поддержка в телеграме: @ABCDSupportBot

Спасибо, что остаётесь с нами!
ABCD.HOST

3D-печать: как мы печатаем собственные компоненты для серверов


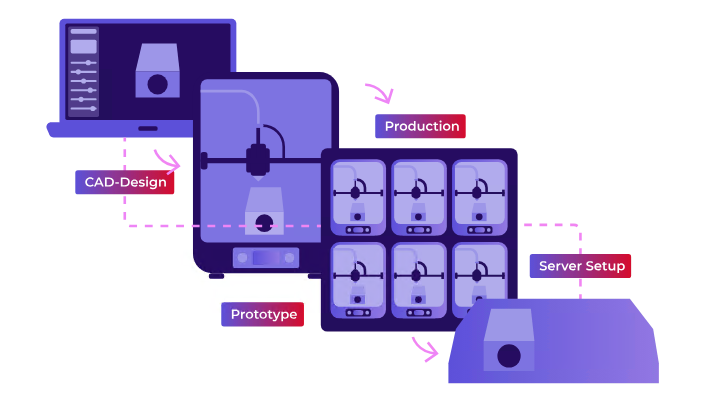
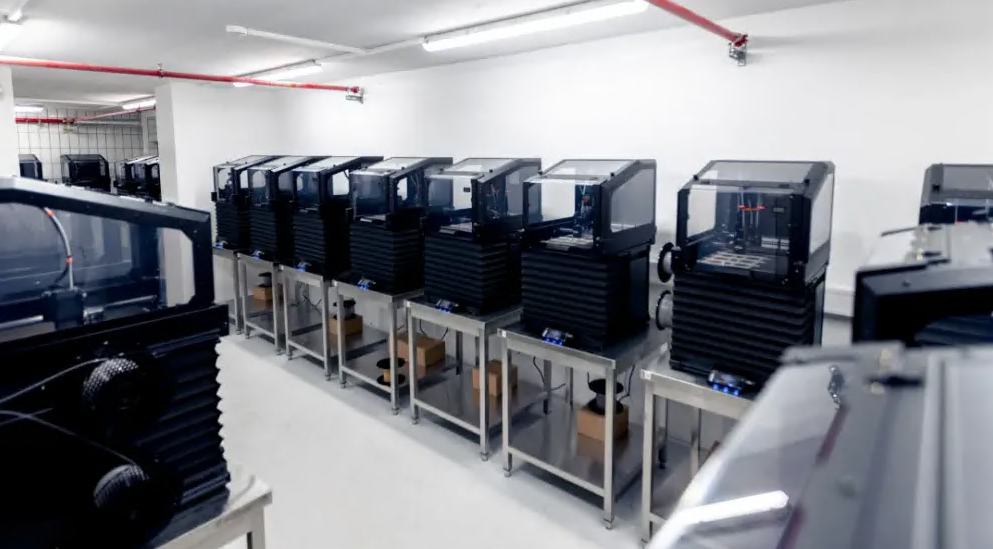
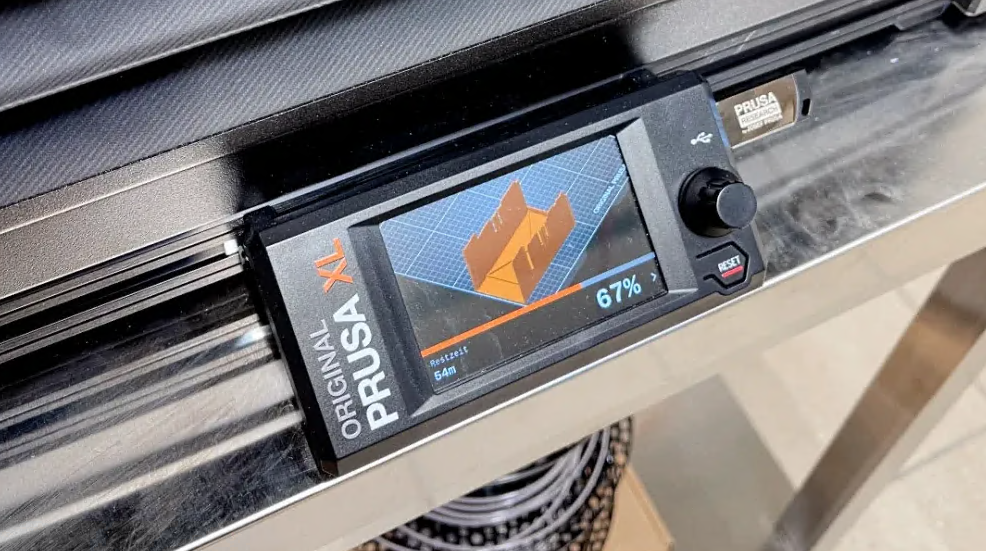
Мы используем нашу ферму 3D-печати для изготовления на заказ небольших деталей для наших серверов, таких как воздуховоды и крепления для жестких дисков. Вместо того чтобы заказывать их, мы разрабатываем, тестируем и производим их непосредственно в нашем цехе по производству оборудования. Это экономит время и деньги и позволяет избежать длинных цепочек поставок. Мы сами разрабатываем и моделируем детали: сначала мы создаем 3D-модель на компьютере и печатаем прототип. После того как деталь проходит серию испытаний, она запускается в серийное производство. Для этого более 40 принтеров Prusa XL работают в среднем по 20 часов в день и производят около 1000 воздуховодов в неделю. В качестве материала мы используем термостойкий пластик PETG.

В Hetzner мы по-прежнему воспринимаем принцип «сделай сам» в самом буквальном смысле. Мы разрабатываем собственное программное обеспечение, проектируем наши центры обработки данных сами и собираем большую часть наших серверов собственными силами. Если при сборке сервера нам когда-либо не хватает мелких деталей — будь то кронштейны или воздуховоды — мы просто печатаем их сами.

Наш последний проект в стиле «сделай сам» — это 3D-печать. На данный момент мы изготовили более 100 000 деталей и не планируем останавливаться.
В этой статье вы узнаете, что стоит за этим и какое отношение к этому имеет бывший мясной магазин.

Почему мы сами печатаем детали для серверов
Что именно мы печатаем? И имеет ли это смысл? Краткий ответ: тысячи компонентов для наших серверов, и да, это того стоит. Подробный ответ:

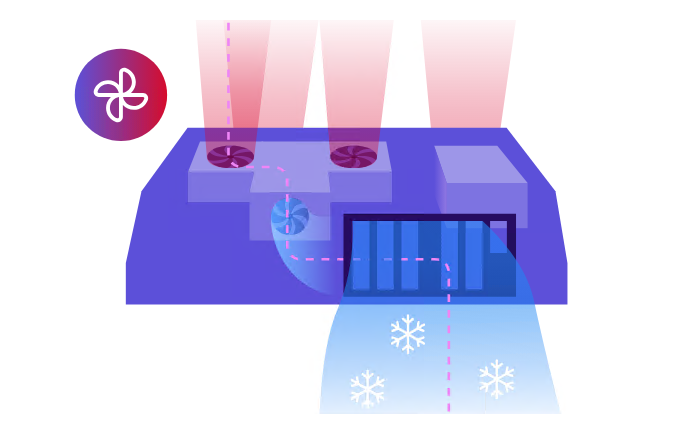
При строительстве и эксплуатации наших центров обработки данных мы уделяем первостепенное внимание эффективности, особенно в вопросах охлаждения. Наши серверы работают круглосуточно и постоянно выделяют тепло, которое необходимо отводить. Мы полагаемся на, пожалуй, наиболее экологичный вариант: свежий воздух. Он циркулирует по системам, поглощает тепло от компонентов и целенаправленно его отводит. Для обеспечения чистоты и эффективности этого процесса нам необходимы эффективные воздуховоды. А поскольку многие наши серверы мы производим сами, нам требуются решения, разработанные специально для этой цели.


Именно здесь на помощь приходит 3D-печать. Она позволяет создавать детали с высокой точностью, соответствующие нашим строгим требованиям. И не только для обеспечения циркуляции воздуха в воздуховодах — нам нужны и другие компоненты, изготовленные на заказ, для крепления кабелей и установки жестких дисков. Мы сами разрабатываем, проектируем и печатаем мелкие детали, вместо того чтобы заказывать их через длительный и дорогостоящий процесс — это просто эффективнее. Это исключает длинные транспортные маршруты и цепочки поставок, а значит, помогает и окружающей среде.

Отдел 3D-печати был запущен в середине 2025 года на нашем заводе по производству оборудования в Гунценхаузене. Наша команда 3D-производителей работает совместно с нашим основным производственным предприятием в Фалькенштайне, где мы собираем наши выделенные серверы, которые затем отправляем на наши предприятия в Германии и Финляндии. Таким образом, ферма 3D-печати расположена непосредственно у источника.

Но как идея превращается в готовый продукт?


От прототипа до серийного производства
Сначала мы проверяем, подходит ли деталь вообще для 3D-печати. ​​На данный момент это включает более 20 различных воздуховодов и множество других мелких деталей. Они идеально подходят, потому что не должны выдерживать экстремальные механические нагрузки, имеют простую геометрическую форму и подвергаются воздействию температур только до 80°C.

Как только мы решаем, что хотим изготовить компонент самостоятельно, мы переходим к моделированию, а затем и к разработке. Для этого команда создает виртуальную модель в нашем программном обеспечении САПР. САПР расшифровывается как «Computer-Aided Design» (система автоматизированного проектирования) и описывает распространенную категорию программного обеспечения, используемого для создания и редактирования 3D-моделей. Практическое преимущество этого заключается в том, что мы можем видеть прямо на экране, в масштабе, все ли детали подходят друг к другу.

Затем мы распечатываем прототип и тестируем его на реальном сервере. Если что-то не так, мы исправляем модель и распечатываем ее заново. Как только компонент подходит, мы переходим к разработке продукта. Если команда одобряет это, начинается серийное производство.

Команда разработчиков в отделе 3D-печати постоянно тестирует и экспериментирует с новыми компонентами. Потребность в индивидуальных решениях так же велика, как и разнообразие наших серверов.

Наша типография работает в непрерывном режиме.
Массовое производство? Как это вообще должно работать? Ежедневно мы производим несколько сотен серверов, значит, нам нужно столько же деталей, напечатанных на 3D-принтере, верно? Именно. Вот почему нам нужны кронштейны и воздуховоды в таких масштабах — и они нужны нам каждый день.

Поначалу в нашем распоряжении было всего несколько принтеров. Со временем это превратилось в полноценную печатную ферму с более чем 40 машинами. Но мы уверены, что на этом количество не остановится.


Если вас интересует плитка на стене: наша типография расположена в бывшем мясном магазине, который раньше был частью супермаркета. Зачем строить новое здание, если мы можем творчески и экологично использовать существующие помещения?

Чтобы справиться с огромным объемом заказов, станки работают в среднем 20 часов в сутки, семь дней в неделю, а иногда и до 24 часов. Производительность впечатляет: мы производим 1000 воздуховодов в неделю. Для этого мы используем около полутонны филамента в месяц. Филамент — это пластиковая нить, которую принтер плавит и наносит слой за слоем. В качестве материала мы используем PETG, прочный пластик, способный выдерживать достаточно высокие температуры. Поскольку серверы работают круглосуточно, внутри может быть очень жарко.

Технологии, лежащие в основе парка самолетов Prusa XL.


Мы выбрали чешский FDM-принтер Prusa XL. FDM расшифровывается как Fused Deposition Modeling (послойное наплавление) и точно описывает описанный выше принцип: принтер нагревает нить и послойно выдавливает ее через тонкое сопло до тех пор, пока деталь не будет готова. У Prusa XL это сопло имеет ширину всего 0,4 мм.

Каждый принтер имеет две печатающие головки, каждая с катушкой филамента. Когда одна катушка пуста, вторая печатающая головка автоматически берет на себя работу, так что в идеальном случае вам не нужно менять катушки или вмешиваться каким-либо другим образом. Каждый принтер использует около двух катушек в неделю, или примерно четыре килограмма.

Чтобы предотвратить взаимные помехи из-за вибраций, каждый принтер устанавливается на отдельном столе.

Объем рабочей области 360 x 360 x 360 мм обеспечивает достаточно места. Это позволяет печатать воздуховоды целиком, без необходимости сборки отдельных деталей. Например, типичный воздуховод имеет размеры 150 x 100 x 96 мм. Поскольку мы используем весь объем рабочей области, мы можем печатать от четырех до шести воздуховодов одновременно, в зависимости от их размеров.

Еще одна полезная функция — возможность точной настройки множества параметров: от температуры сопла и нагреваемой платформы до высоты слоя и скорости печати. ​​Нам потребовалось некоторое время, чтобы найти идеальные настройки для наших деталей, но это того стоило.

Это больше, чем просто эксперимент.
Если деталь не подходит, мы её подгоним — даже если для этого потребуется прямой 3D-принтер. Это экономит нам время и деньги, а также снижает зависимость от цепочек поставок. Кроме того, мы можем производить детали, которые, возможно, даже не доступны для покупки.

Потенциал на будущее огромен: вопрос уже не в том, работает ли 3D-печать, а в том, как сделать наши компоненты еще более прочными, а процессы — еще более стабильными. Особенно интересно для нас наблюдать, какие материалы, профили печати и варианты автоматизации сделают ее использование еще более эффективным в будущем. Возможно, однажды мы даже сможем печатать более крупные серверные компоненты целиком — кто знает.

Дело в том, что 3D-печать в компании Hetzner — это уже не эксперимент, а неотъемлемая часть нашего производства.

Новый сервер Hetzner GEX45 с графическим процессором: обновление Blackwell для ваших проектов в области искусственного интеллекта


Новый сервер GEX45 с графическим процессором: возможности искусственного интеллекта по доступной цене.
Компания Hetzner представляет новый GEX45 — сервер с графическим процессором, обеспечивающий профессиональную производительность по привлекательной цене начального уровня. В основе системы лежит NVIDIA RTX PRO 4000 Blackwell SFF Edition с 24 ГБ видеопамяти GDDR7 ECC. Благодаря тензорным ядрам 5-го поколения с поддержкой FP4 и ядрам RT 4-го поколения, GEX45 особенно хорошо подходит для выполнения задач искусственного интеллекта и тонкой настройки ИИ. GEX45 обеспечивает высокую производительность и за пределами приложений ИИ; к областям его применения также относятся 3D-рендеринг, САПР-приложения и видеопроизводство.

Процессор Intel Core i5-13500 13-го поколения «Raptor Lake» обеспечивает высокую производительность. Он имеет шесть высокопроизводительных ядер и восемь энергоэффективных ядер, в общей сложности 20 потоков. 64 ГБ оперативной памяти DDR4 обеспечат достаточный запас для ресурсоемких приложений, а два твердотельных накопителя NVMe по 512 ГБ гарантируют быструю загрузку и доступ к данным.

В комплект GEX45 входит IPv4-адрес, который можно приобрести за 214,00 евро / 249,00 долларов США в месяц плюс единовременный сбор за настройку в размере 209,00 евро / 249,00 долларов США. Это делает GEX45 идеальным выбором для тех, кто ищет мощный сервер начального уровня для профессиональных задач, связанных с графическими процессорами.
www.hetzner.com/dedicated-rootserver/gex45/

НАДЕЖНОЕ СЕТЕВОЕ СОЕДИНЕНИЕ: 50,12 Тбит/с И НОВЫЙ ПОЯВИТЕЛЬ В ВАРШАВЕ
Мы постоянно расширяем общую внешнюю пропускную способность, чтобы вы могли пользоваться мощным и надежным сетевым соединением. Недавно мы увеличили пропускную способность нескольких исходящих каналов и подключили к сети другие:

Приватные пиринги:
  • 400 Гбит/с CDN77 (HEL)
  • 100 Гбит/с 1CentHost (Франция)
  • 100 Гбит/с Aurologic (HEL1)
  • 100 Гбит/с BackboneDirect (AMS)
  • Группа передачи данных 100 Гбит/с (FRA)
  • 100 Гбит/с EliteServices (AMS)
  • EliteServices (STO) 100 Гбит/с
  • 100 Гбит/с Exatel (Франция)
  • 100 Гбит/с Fastly (PAR)
  • Глобальный слой 100 Гбит/с (AMS)
  • 100 Гбит/с Lumaserv (Франция)
  • 100 Гбит/с Netshield (HEL)
  • 100 Гбит/с UTG (Франция)
  • 100 Гбит/с Wilhelm.Tel (Франция)
  • 100 Гбит/с Worldstream (AMS)

Точки взаимодействия:
  • 100 Гбит/с OCIX (Франция)
  • 100 Гбит/с ERA-IX (VIE)
  • 400 Гбит/с GNM-IX (HEL)


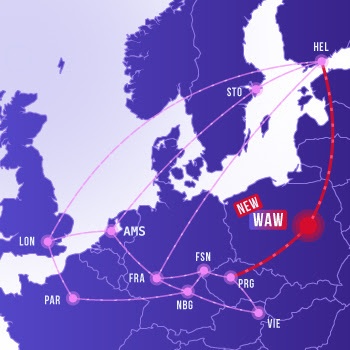
Кроме того, мы расширили нашу сеть, включив в нее новую точку присутствия (PoP) в Варшаве. Это улучшает доступ к локальным сетям доступа для клиентов в Восточной Европе и снижает задержку. В то же время, новое местоположение повышает надежность нашей сетевой инфраструктуры, поскольку точка присутствия в Варшаве служит дополнительным резервным маршрутом для нашего соединения по подводному кабелю C-Lion1 с Финляндией.
www.hetzner.com/unternehmen/rechenzentrum/

Хетцнер в очередной раз вошел в число 50 лучших игроков Баварии.
Компания Hetzner в очередной раз вошла в число 50 самых быстрорастущих средних компаний Баварии в 2026 году. Министерство экономики, регионального развития и энергетики Баварии в шестой раз удостоило компанию звания «50 лучших компаний Баварии». Министр экономики Баварии Хуберт Айвангер вручил награду генеральному директору Штефану Конвичковой и представителю компании Кристиану Фицу 30 июля во дворце Шляйсхайм в Мюнхене, Германия.


Ежегодно Свободное государство Бавария этой наградой отмечает малые и средние предприятия, находящиеся в непосредственном владении и управляемые собственниками, которые выделяются своими темпами роста выше среднего, предпринимательскими успехами и созданием новых рабочих мест.

Один из крупнейших ютуберов, специализирующихся на технологиях, посетил Hetzner.
Смотрите, кто заглянул! К нам приехал Линус из Tech Tips, и вместе со своей командой он осмотрел крупнейший в Германии парк центров обработки данных в Фалькенштайне.
Оказалось, что канадская энергетика и немецкая инфраструктура представляют собой довольно удачное сочетание.

Эксперимент на основе логических выводов: что мы узнали за одну неделю


Вкратце:
Эксперимент оказался очень успешным. В целом, конструкция нашего API для вывода результатов и аппаратная часть, лежащая в его основе, были надежными и обеспечили очень хорошие результаты. Спрос на вывод результатов оказался намного выше, чем мы ожидали. Для удовлетворения высокого спроса на большие модели нам потребуются дальнейшие улучшения. Пока мы будем вносить эти улучшения, эксперимент продолжится в меньшем масштабе, с меньшими моделями.

Недавно мы запустили наш эксперимент по инференции: API для инференции, который позволяет использовать большие языковые модели (LLM), размещенные на нашей инфраструктуре. Вы можете подключить к нему любой агент, тестовую среду или инструмент для программирования по вашему выбору и использовать наши LLM бесплатно. Таким образом, вы можете протестировать работу LLM на мощном оборудовании, а мы тем временем будем накапливать опыт работы с такими моделями.

Теперь, когда эксперименту по выводу данных исполнилась неделя, мы хотели бы поделиться с вами некоторыми сведениями о том, как он работает, о том, что мы узнали, и о том, каким может быть его будущее. Для этого мы хотели бы показать вам хронологию экспериментальной платформы Hetzner и всех экспериментов, проведенных на ней до настоящего времени.


T — 4 месяца: внедрение платформы Hetzner Experiments Platform с OpenClaw.
С тех пор, как мы начали предлагать нашим клиентам серверы с графическими процессорами, мы тестировали способы обслуживания LLM внутри компании. Благодаря многолетнему опыту работы с Kubernetes, мы смогли создать внутреннюю платформу для вывода результатов, которую использовали для тестирования различных конфигураций серверов и программного обеспечения для обслуживания LLM.

В итоге мы остановились на стеке, состоящем из нескольких серверов GEX131, vLLM и Open WebUI. Эта комбинация позволила нам запустить несколько небольших LLM-моделей, которые мы могли использовать для некоторых внутренних приложений производственного уровня. Это также позволило нам тестировать и оценивать производительность более крупных моделей внутри компании.

В начале 2026 года OpenClaw стал очень обсуждаемой темой в сфере искусственного интеллекта. Многие энтузиасты использовали виртуальные машины Hetzner Cloud для тестирования OpenClaw, но столкнулись с трудностями в безопасной настройке сервера. Чтобы помочь нашим клиентам в решении этой проблемы, мы решили предложить OpenClaw в виде предварительно настроенного экземпляра.

Мы быстро создали новую платформу, которая позволила бы нам предлагать не только OpenClaw, но и другие услуги и продукты, с которыми мы, возможно, захотим поэкспериментировать в будущем. Это позволило бы быстро внедрять изменения и проводить эксперименты, при этом предоставляя меньше гарантий, чем наши более зрелые продукты. Одной из ключевых особенностей стало бы ценообразование: первоначально мы предлагали бы все эксперименты совершенно бесплатно.

OpenClaw также предоставил возможность получить опыт работы с самостоятельным размещением систем вывода. Наш OpenClaw поставлялся с предварительно настроенным собственным API для вывода. API не был общедоступным, а был ограничен OpenClaw, поэтому мы могли в определенной степени контролировать объем запросов. Предлагая вывод только через OpenClaw, мы могли опробовать несколько небольших моделей с открытыми весами в различных конфигурациях. А наши клиенты получали продукт на основе ИИ, полностью разработанный для ЕС.

Чтобы продемонстрировать уникальность платформы Hetzner Experiments Platform, мы создали для нее отдельную панель интерфейса на сайте experiments.hetzner.com

Этот ограниченный эксперимент с OpenClaw дал нам много ценных выводов:
  • Небольшие модели, такие как Qwen 3.6, оказались достаточными для большинства сценариев использования OpenClaw.
  • GEX131 с одной видеокартой RTX PRO 6000 Blackwell был достаточен для небольших моделей LLM, но не мог эффективно запускать большие модели.
  • Многие пользователи высоко оценили тот факт, что это полностью разработано для стран ЕС.
  • Качество кода OpenClaw было постоянной проблемой: каждый новый релиз OpenClaw приносил новые трудности, поскольку количество ошибок в исходном коде было довольно велико.

T — 1 месяц: получение специализированного оборудования
В компании Hetzner наши команды разработчиков оборудования постоянно работают над новыми моделями серверов. Одной из таких моделей стал новый сервер, созданный по индивидуальному заказу, в котором вместо одной видеокарты GEX131 размещено восемь графических процессоров RTX PRO™ 6000 Blackwell. Это значительно улучшает возможности сервера для работы с более крупными моделями.

С помощью некоторых из этих серверов с 8 графическими процессорами мы могли бы предлагать нашим клиентам более крупные модели. Эксперимент OpenClaw уже показал, что наши клиенты заинтересованы в темах, связанных с искусственным интеллектом и выводом данных. Однако качество программного обеспечения OpenClaw оставалось проблемой.

Для решения этой проблемы мы решили предложить вывод результатов напрямую в виде API, соответствующего спецификации OpenAI, который мог бы использовать каждый, без необходимости обращаться в OpenClaw. Все, что им понадобится, — это токен авторизации, который они смогут сгенерировать через experiments.hetzner.com на отдельной вкладке «Вывод результатов».

T — 2 недели: сравнительный анализ и выбор подходящих моделей.
Затем последовало множество сравнительных анализов и исследований рынка.

Мы составили список программ магистратуры в области права, которые хотели бы предложить:
  • Qwen/Qwen3.6-35B-A3B
  • Код Kimi-K2.7
  • GLM-5.2
  • DeepSeek-V4-Flash-0731

Qwen продолжит эксперимент OpenClaw в качестве меньшей, «базовой» модели. Kimi предложит альтернативу двум крупнейшим моделям, GLM и DeepSeek, ориентированную на программирование. Каждая из этих моделей представляет собой новейшую версию соответствующего семейства LLM.

Единственным исключением был Kimi: K3 уже вышел и обещал отличные результаты в публичных тестах. Однако очень специфические лицензионные требования K3 не позволяли нам предложить его в качестве бесплатного эксперимента.

T — 1 неделя: заключительные приготовления
В рамках заключительной подготовки к эксперименту по формированию выводов некоторые внутренние компоненты были переработаны, чтобы справиться с ожидаемым высоким спросом.

Маршрутизация запросов на вывод значительно улучшилась благодаря внедрению llm-d и внесению изменений в некоторые компоненты маршрутизации, разработанные нами внутри компании. Такие функции, как перенос kv-кэша в оперативную память хоста, также обещали существенное повышение производительности.

Мы также добавили еще несколько специализированных серверов с 8 видеокартами и выделили каждый из них для запуска DeepSeek, GLM или Kimi. А серверы GEX131 с одной видеокартой мы используем для обслуживания более компактной модели Qwen 3.6.

T — 0 часов: запуск
Оценить спрос на эксперимент по анализу выводов было сложно заранее. Чтобы подстраховаться, мы распределили запуск на несколько дней:

7 августа мы запустили новые модели и эксперимент по выводу результатов на платформе Hetzner Experiments. Это дало первым пользователям выходные, чтобы выявить любые проблемы, которые мы могли пропустить. После выходных, 10 августа, мы начали активно информировать наших клиентов об эксперименте. Мы ожидали, что сарафанное радио в конечном итоге также повысит спрос.

T + 6 часов: достигнут лимит вместимости.
Информация распространялась быстро: уже через несколько часов мы заметили резкое увеличение запросов к API для вывода результатов. Спрос превзошел наши самые оптимистичные ожидания и продолжал расти высокими темпами.

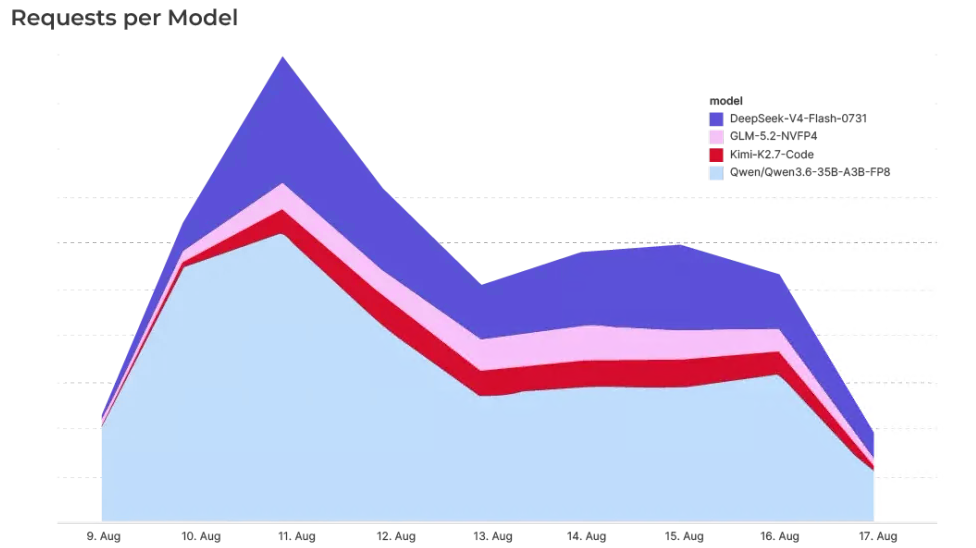
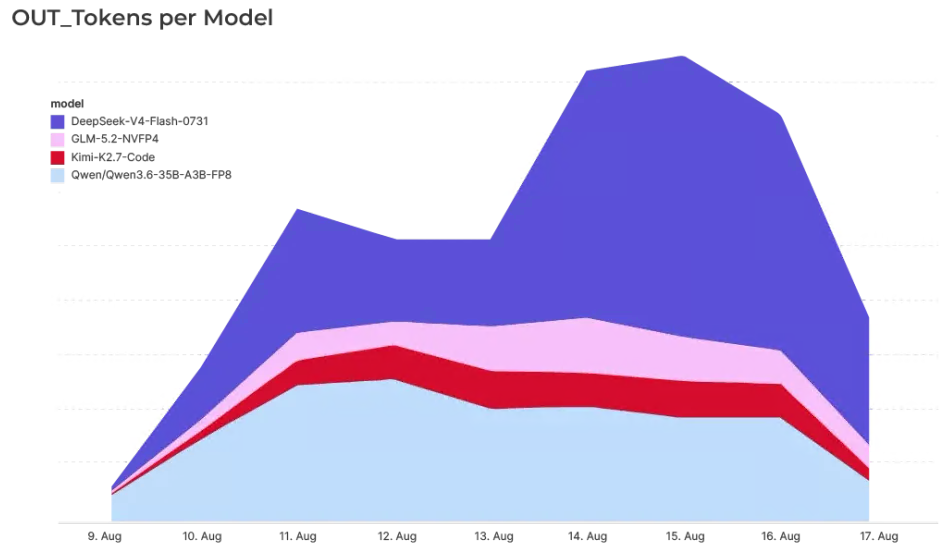
Модель Qwen 3.6, которая была моделью по умолчанию для OpenClaw, оказалась самой популярной в первый день, как по количеству запросов, так и по количеству сгенерированных токенов. Другие модели также пользовались высоким спросом, но значительно отставали от Qwen.

Наша система смогла обеспечить достаточную пропускную способность для обработки запросов, но мы уже заметили увеличение задержки:

Для 99-го процентиля времени до получения первого токена (TTFT) наблюдались кратковременные скачки в некоторых моделях, но в целом показатели оставались достаточно хорошими, составляя в большинстве случаев от 5 до 10 секунд.

Ещё одним сюрпризом стало резкое увеличение количества экземпляров OpenClaw. Хотя ожидался некоторый рост спроса, число экземпляров в первый же день резко возросло. Наш небольшой кластер Kubernetes для запуска экземпляров OpenClaw быстро достигал предела своей пропускной способности. Поэтому мы отключили вкладку OpenClaw на experiments.hetzner.com для всех учетных записей, которые ещё не вошли в платформу Hetzner Experiments Platform.

T + 1 день: как справиться с спросом
На второй день эксперимента количество запросов на все модели резко возросло, и это повторилось снова.

Стали проясняться закономерности использования:
  • Наибольший интерес вызвал DeepSeek. Многие пользователи сообщили о благоприятных результатах тестирования.
  • Квен оставалась популярной, получала очень много небольших запросов.
  • Модели GLM и Kimi также пользовались большим спросом, но гораздо меньшим, чем две другие. У модели GLM была самая высокая задержка, и она нуждалась в дополнительной доработке.
  • Мы не регистрируем никаких данных о запросах, но наши показатели токенов указывают на то, что многие пользователи в это время все еще запускали тесты производительности.
Однако такое количество запросов превышало возможности нашей экспериментальной инфраструктуры. Время получения первого токена (TTFT) резко возросло, достигнув пика почти в 10 минут для 99-го процентиля, что временами делало API практически непригодным для использования. Наш эксперимент не был рассчитан на такой масштаб запросов, и это сказалось на результатах.

Особенно сложной задачей было большое количество небольших, одновременно обрабатываемых запросов. Чтобы лучше справляться с этим, мы сократили количество принимаемых нами параллельных запросов.

Мы также получили множество отзывов относительно настроек логики различных моделей, которые некоторые пользователи сочли неинтуитивными.


T + 2 дня: дополнительные настройки, больше оборудования
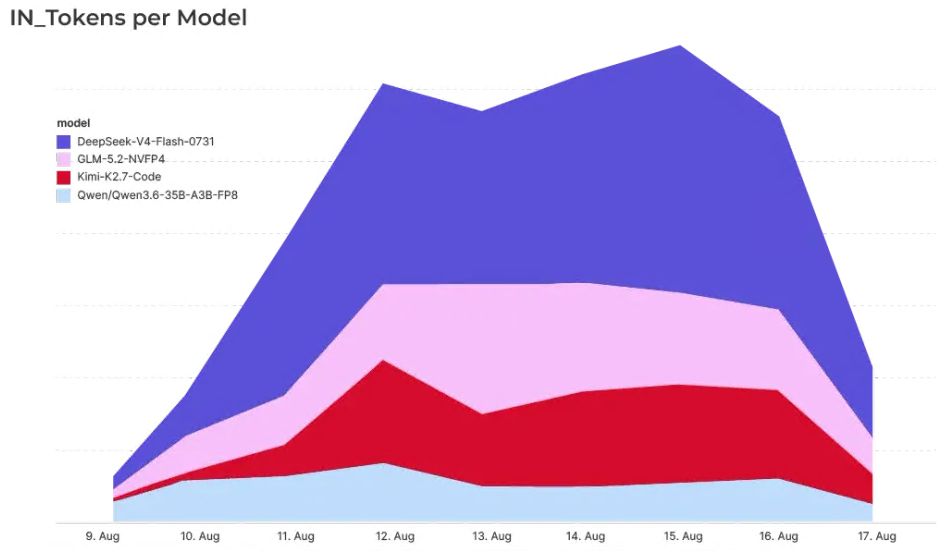
Спрос на обработку данных еще больше возрос, доведя нашу инфраструктуру обработки данных до предела. В то время как количество запросов к конечной точке API снижалось, общее количество входных токенов продолжало расти.


Стремясь увеличить вычислительную мощность, мы смогли собрать еще несколько специализированных серверов с 8 видеокартами и добавили их в пул, обслуживающий GLM, поскольку эта модель в то время испытывала наибольшие трудности.

Теперь закономерности использования стабилизировались и будут наблюдаться до конца недели:
  • DeepSeek столкнулся со все более сложными запросами, содержащими огромное количество входных и выходных токенов.
  • Квен продолжала получать очень большое количество мелких запросов.
  • GLM и Kimi получили запросы среднего размера, но на более низком уровне, чем две предыдущие компании.
  • В среднем количество запросов было больше, чем в первый день. Это указывало на более широкое использование сервиса в практических целях, с большими массивами реальных данных.
  • Благодаря нашим доработкам, во всех моделях наблюдалось повышение производительности.
  • В часы пик большое количество запросов тратило минуты на ожидание в очереди, прежде чем сервер с графическим процессором мог начать обработку запроса на вывод результатов.
В течение недели мы опробовали множество улучшений: общие ограничения скорости обработки запросов были снижены, чтобы дать большему количеству пользователей возможность принять участие в эксперименте. Некоторые модели использования показались нам вредоносными, поэтому мы предприняли шаги по ограничению скорости и фильтрации таких запросов. Фактическое использование также отличалось от результатов наших бенчмарков. Мы выяснили, что для некоторых моделей меньшее количество одновременных запросов на экземпляр является наиболее оптимальным с точки зрения пропускной способности. Благодаря этому изменению общая пропускная способность токенов в эксперименте увеличилась.

Мы также расширили парк оборудования для OpenClaw. Первые пользователи OpenClaw продолжали создавать всё больше экземпляров OpenClaw. Однако количество программных проблем с OpenClaw также увеличилось: многие экземпляры OpenClaw неправильно настраивались по запросу пользователей и в итоге оказывались в нерабочем состоянии.

T + 7 дней: подведение итогов и сокращение масштабов эксперимента.
Оглядываясь назад, спустя неделю, мы многому научились:
  • Спрос оказался намного выше, чем мы ожидали, как по количеству пользователей, так и по числу запросов и токенов на запрос. Серверы с 8 графическими процессорами доказали свою способность обрабатывать большие модели, но спрос оказался слишком высок для небольшого количества серверов, участвовавших в нашем эксперименте. Метрики также выявили некоторые узкие места в программном обеспечении, используемом для маршрутизации и обработки запросов.
  • Для устранения некоторых из этих узких мест потребуется исключить оборудование из пула, используемого для API вывода данных, чтобы протестировать некоторые изменения. Мы также рассмотрим возможность улучшения нашей документации, добавив больше подробностей и руководств, чтобы упростить ее использование для начинающих.
  • Мы также пересмотрим наш выбор LLM на основе рассмотренных нами метрик. Возможно, мы также рассмотрим другие варианты использования, такие как переранжирование или встраивание, как это используется в конвейерах RAG. Кроме того, мы критически оценим эксперимент OpenClaw и усилия, необходимые для его поддержки.
  • Эксперимент по выводу данных продолжится, но в уменьшенном масштабе: мы продолжим предоставлять доступ к небольшим моделям, таким как Qwen 3.6 и 3.8, но сделаем перерыв в предоставлении доступа к большим моделям.

Попробуйте сами на experiments.hetzner.com Мы продолжим запускать новые проекты и экспериментировать, чтобы увидеть, что еще возможно. Следите за обновлениями, чтобы узнать, что будет дальше.